Technologie
•
17 min
KI-Agenten planen bei jedem Lauf neu, mit schwankenden Ergebnissen, steigenden Kosten und Abhängigkeit vom Modellanbieter. Compiled AI trennt Planung und Ausführung und bringt Souveränität, planbare Kosten und Wiederholgenauigkeit in wiederkehrende Prozesse.


Nicolas Bartschat
Nicolas Bartschat ist Gründer und Geschäftsführer der AI CONSULT GmbH. Er berät Organisationen bei der Einführung von KI- und Automatisierungslösungen mit Fokus auf Praxistauglichkeit und messbarem ROI.
Das Wichtigste in Kürze
Die Leistungsfähigkeit der Modelle ist für die meisten Unternehmensprozesse nicht mehr der Engpass. Die Engpässe heißen Verlässlichkeit und planbare Kosten.
KI-Agenten, die bei jedem Lauf neu planen, liefern nicht garantiert zweimal dasselbe Ergebnis, ihre Kosten wachsen mit jedem Lauf, und jeder Prozesslauf hängt an Verfügbarkeit, Preisen und Modellversionen weniger großer Anbieter. Für wiederkehrende, prüfpflichtige Prozesse ist das ein struktureller Nachteil.
Compiled AI trennt Planung und Ausführung: Ein Modell entwirft den Prozess einmal, validiert und testet ihn. Ausgeführt wird ein versionierter, deterministischer Plan ohne Modellaufruf im Steuerfluss. Damit adressiert der Ansatz drei zentrale Themen der aktuellen KI-Einführung: Souveränität in der Ausführung, Kosten und Wiederholgenauigkeit.
Erste Messungen einer Forschungsgruppe um Stanford und Harvard zeigen einen Break-even nach rund 17 Läufen, 57-fach weniger Tokens bei 1.000 Läufen und einen vollständig reproduzierbaren Steuerfluss.
Compiled AI ist kein Dogma und ersetzt Agenten nicht. Ob sich der Ansatz lohnt, entscheidet sich pro Prozess. Dieses Whitepaper liefert dafür ein Entscheidungsraster und einen Fahrplan für den Einstieg.
1. Die Intelligenz ist nicht mehr der Engpass
Kaum eine Technologie hat sich so schnell verbreitet wie generative KI. PC, Internet und Mobile brauchten jeweils viele Jahre bis zur breiten Nutzung, ChatGPT, Claude und Gemini wenige Monate. In den Kernprozessen der Unternehmen ist davon erstaunlich wenig angekommen. Die MIT-Studie „The GenAI Divide“ kam 2025 zu dem Ergebnis, dass rund 95 Prozent der untersuchten Organisationen keinen messbaren Ertrag aus ihren GenAI-Initiativen sehen (1). Über die Methodik lässt sich streiten, die Richtung deckt sich mit dem, was wir in Projekten sehen: Zwischen dem, was Frontier-Modelle können, und dem, was in End-to-End-Prozessen tatsächlich läuft, liegt eine Lücke von mehreren Jahren.
An den Modellen liegt das selten. Für die typische Unternehmensaufgabe, also Daten aus mehreren Systemen holen, prüfen, verdichten und weitergeben, reichen heute bereits mittelgroße Modelle. Die Lücke entsteht woanders: In den meisten Unternehmen halten Menschen die Systeme zusammen. ERP, MES, CRM, QMS, DMS und Dateiablagen laufen nebeneinander, jede Übergabe dazwischen ist ein manueller Schritt. Ein Schichtbericht, ein Monatsreporting oder eine Reklamationsakte entsteht, weil qualifizierte Mitarbeitende Daten zusammensuchen, abgleichen, übertragen und weiterreichen. Das ist manuelle, wenig wertschöpfende Arbeit, die viel Zeit bindet.

Abbildung 1: Heute bilden Menschen die Integrationsschicht zwischen isolierten Systemen und Datensilos.
Die naheliegende Idee lautet: Wir setzen einen KI-Agenten genau an diese Stelle. Er liest die Systeme, versteht die Anfrage und schreibt den Bericht. Für explorative Aufgaben ist das richtig. Für wiederkehrende Prozesse stößt der Ansatz auf drei Hürden, die sich mit besseren Modellen nicht von selbst erledigen.
2. Drei Hürden: Verlässlichkeit, Kosten, Abhängigkeit
2.1 Gleicher Input, anderes Ergebnis
Ein KI-Agent plant bei jedem Lauf neu. Er findet einen plausiblen Lösungsweg, beim nächsten Lauf einen anderen, ebenso plausiblen. Das ist keine Schwäche einzelner Produkte, sondern folgt aus der Funktionsweise. Selbst bei Temperatur 0, der Einstellung für maximal gleichförmige Antworten, arbeiten Sprachmodelle in der Praxis nicht deterministisch. Thinking Machines Lab hat 2025 dieselbe Anfrage 1.000-mal an ein großes Open-Source-Modell gestellt und 80 verschiedene Antworten erhalten (2). Eine Ursache sind Rechenoptimierungen auf den Servern, deren Ergebnis von der aktuellen Auslastung abhängt. Deterministische Inferenz ist technisch möglich, kostet aber Geschwindigkeit und ist bei kommerziellen Schnittstellen nicht der Standard.
In verketteten Prozessen multipliziert sich die Unsicherheit. Liegt die Trefferquote pro Schritt bei 95 Prozent, ist ein Prozess mit zehn Schritten nur noch in rund 60 Prozent der Fälle vollständig korrekt, bei 20 Schritten in rund 36 Prozent. Der Benchmark τ-bench misst genau diese Eigenschaft: nicht, ob ein Agent eine Aufgabe einmal löst, sondern ob er sie in k Wiederholungen jedes Mal löst. GPT-4o kam im Szenario Einzelhandel bei acht Wiederholungen auf weniger als 25 Prozent (3). Neuere Modelle schneiden besser ab, das Muster bleibt.

Abbildung 2: Agentische Ausführung. Dieselbe Anfrage erzeugt in drei Läufen drei verschiedene, jeweils plausible Ergebnisse.
Für einen Textentwurf ist Varianz ein Vorteil. Für einen Schichtbericht, eine Zahlungsfreigabe oder eine Konformitätserklärung ist sie ein Risiko. Kritische Prozesse müssen bei jedem Lauf exakt gleich ablaufen.
2.2 Der Tokenpreis fällt, die Rechnung steigt
Der Preis pro Token sinkt rasant. Für gleiche Leistungsfähigkeit fallen die Kosten nach Analysen von a16z um etwa den Faktor zehn pro Jahr (4), Epoch AI misst je nach Aufgabe noch steilere Rückgänge (5). Trotzdem wachsen die KI-Budgets. Drei Effekte überlagern sich: Unternehmen automatisieren mehr Prozesse, Reasoning-Modelle verbrauchen pro Aufgabe ein Vielfaches an Tokens, und agentische Systeme rufen das Modell bei jedem Lauf und oft bei jedem Schritt auf. Google verarbeitete im Mai 2024 rund 9,7 Billionen Tokens pro Monat, ein Jahr später über 480 Billionen (6). Prognosen, die die F.A.Z. auf Basis von BCG, Gartner und Goldman Sachs aufbereitet hat, erwarten bis 2030 einen um den Faktor 2,6 niedrigeren Durchschnittspreis pro Token, aber einen 21-fachen Verbrauch und damit rund 8-fach höhere Tokenkosten (7).
Wer jeden Prozess agentisch ausführt, koppelt seine Betriebskosten an Volumen und Modellwahl. Gartner erwartet, dass bis Ende 2027 mehr als 40 Prozent der agentischen KI-Projekte eingestellt werden, vor allem wegen steigender Kosten, unklarem Nutzen und unzureichender Risikokontrollen (8).
2.3 Jeder Lauf hängt am Modellanbieter
Die dritte Hürde wird in der Diskussion oft übersehen. Wird ein Prozess agentisch ausgeführt, ist das Modell bei jedem einzelnen Lauf beteiligt. Damit hängt der Betrieb an Faktoren, die ein Unternehmen nicht steuert: an der Verfügbarkeit der Schnittstelle, an Nutzungslimits, an Preisänderungen, an Modellversionen, die aktualisiert oder abgekündigt werden und sich danach anders verhalten, und an den Nutzungsbedingungen weniger, überwiegend US-amerikanischer Anbieter. Jeder Lauf bedeutet außerdem, dass Prozessdaten das eigene Haus verlassen.
Für einen Chat-Assistenten ist das hinnehmbar. Für den Monatsabschluss, die Freigabe von Lieferungen oder den Schichtbericht ist es ein Betriebsrisiko. Souveränität heißt hier nicht, auf leistungsfähige Modelle zu verzichten, sondern die Ausführung kritischer Prozesse von ihnen unabhängig zu machen.
3. Drei Wege und eine Empfehlung
Unternehmen, die einen datenintensiven Routineprozess automatisieren wollen, haben im Kern drei Optionen:
Weg | Was passiert | Konsequenz |
|---|---|---|
Nicht automatisieren | Der Prozess bleibt manuell. | Qualität bleibt, Tempo fällt zurück. Fachkräfte bleiben in manuellen, wenig wertschöpfenden Aufgaben gebunden. |
100 % agentisch | Die KI baut den Prozess und führt jeden Lauf selbst aus. | Schnell gebaut, aber nicht reproduzierbar, im Dauerbetrieb teuer und bei jedem Lauf vom Modellanbieter abhängig. |
Compiled AI | Die KI baut den Prozess, Software führt ihn aus. | Einmal gebaut, jeder Lauf gleich. Planbare Kosten, Ausführung unabhängig vom Modell. |
Der Begriff ist neu, das Prinzip nicht. Ein Compiler übersetzt Quellcode einmal in ausführbaren Code, danach läuft das Programm ohne Compiler. Compiled AI überträgt dieses Muster auf KI: Das Modell ist der Compiler, nicht die Ausführungsumgebung. Klassische regelbasierte Automatisierung war deterministisch, aber aufwendig im Aufbau, und jede Prozessänderung war ein eigenes Projekt. Agenten sind schnell gebaut, im Betrieb aber schwer berechenbar. Compiled AI verbindet die Bauzeit des Agenten mit der Betriebssicherheit klassischer Software. Die Antwort ist nicht weniger KI, sondern KI an der richtigen Stelle.
4. Was Compiled AI ist und was nicht
Ein Forschungsteam von XY.AI Labs, Stanford, Cornell und Harvard Medical School hat das Paradigma im April 2026 formal beschrieben (9). Drei Eigenschaften definieren es:
Einmaliger Modellaufruf. Das Modell arbeitet in der Designtime, nicht bei jeder Transaktion.
Kein Modellaufruf im Steuerfluss. Welche Systeme in welcher Reihenfolge abgefragt, welche Regeln angewendet und welche Ausgaben erzeugt werden, steht fest im Code. Wo in der Runtime, also bei der Ausführung, dennoch ein Modell gebraucht wird, etwa um ein unstrukturiertes PDF auszulesen, ist das ein eng begrenzter Aufruf mit festem Ein- und Ausgabeschema.
Verpflichtende, mehrstufige Validierung vor dem produktiven Einsatz.
Der zweite Punkt ist die wichtigste Präzisierung für die Praxis. Compiled AI bedeutet nicht, dass bei der Ausführung nie ein Modell beteiligt ist. Es bedeutet, dass kein Modell darüber entscheidet, welcher Schritt als Nächstes kommt. Die Abfolge steht fest, einzelne Modellaufrufe sind darin klar begrenzte Werkzeuge.
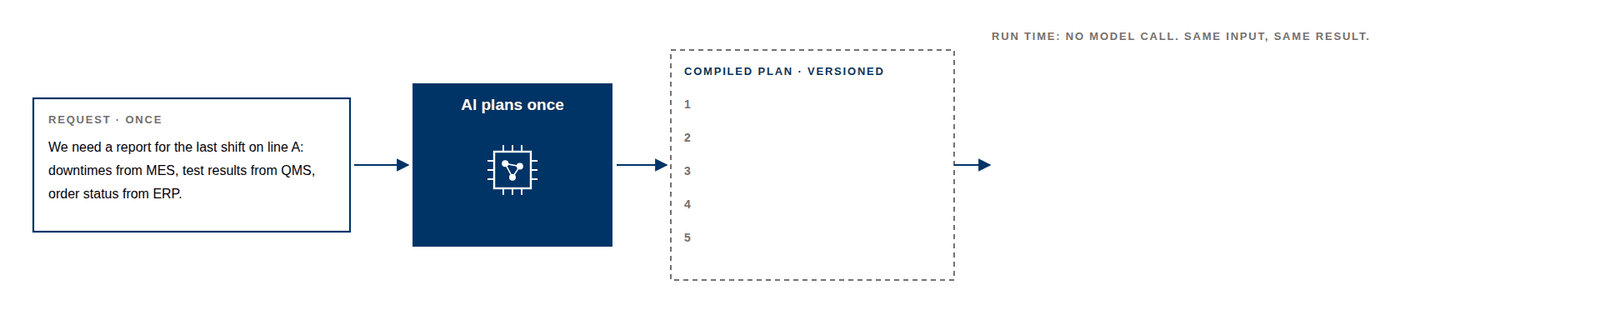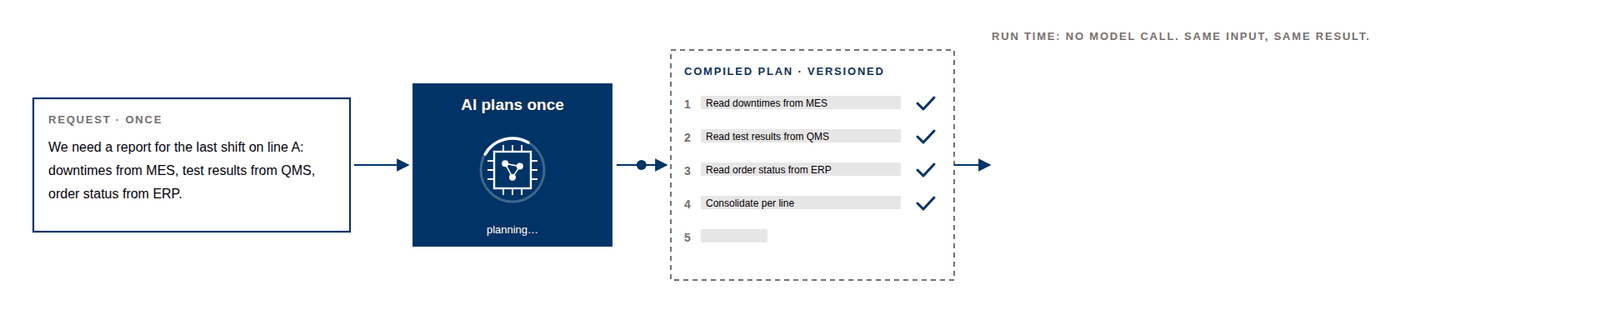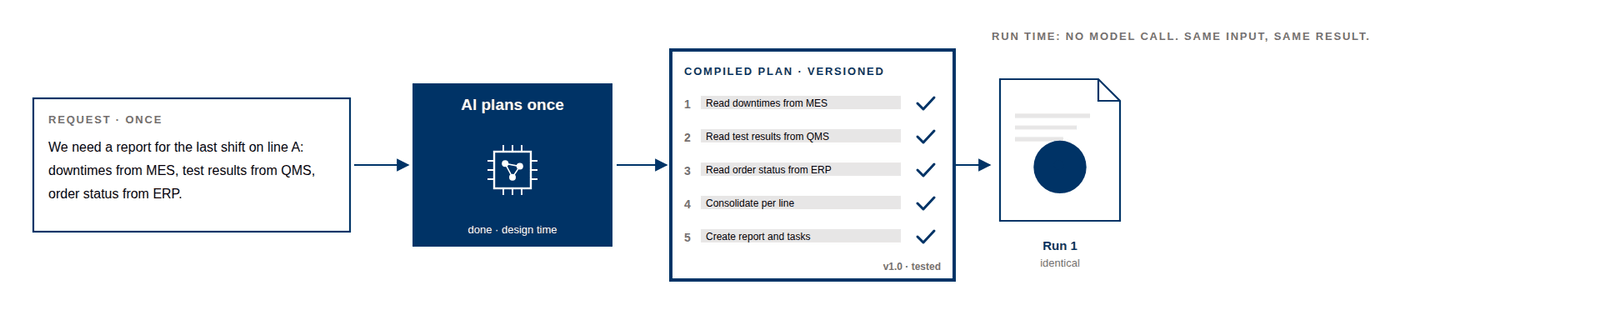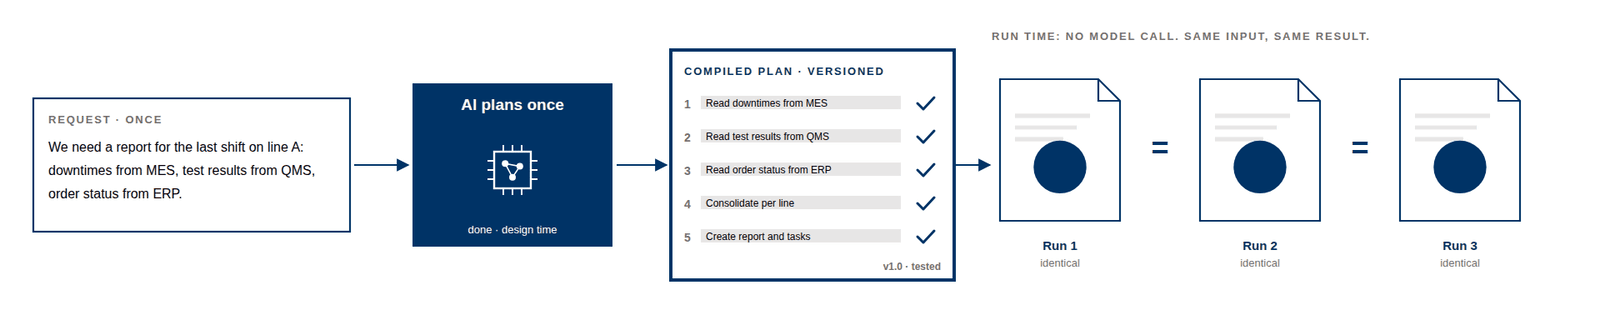
Abbildung 3: Compiled AI. Die KI plant einmal, der versionierte Plan liefert in jedem Lauf dasselbe Ergebnis.
4.1 Designtime: vom Satz zum Plan
In der Designtime beschreibt ein Mensch den gewünschten Prozess in natürlicher Sprache. Ein Planner-Modell übersetzt die Beschreibung in einen typisierten Plan. Dieser wird gegen die echten Schnittstellen, Datenschemata und Sicherheitsregeln validiert, in einem Testlauf ohne Seiteneffekte durchgespielt und so lange nachgebessert, bis er sauber durchläuft. Erst dann gibt ein Mensch ihn frei.
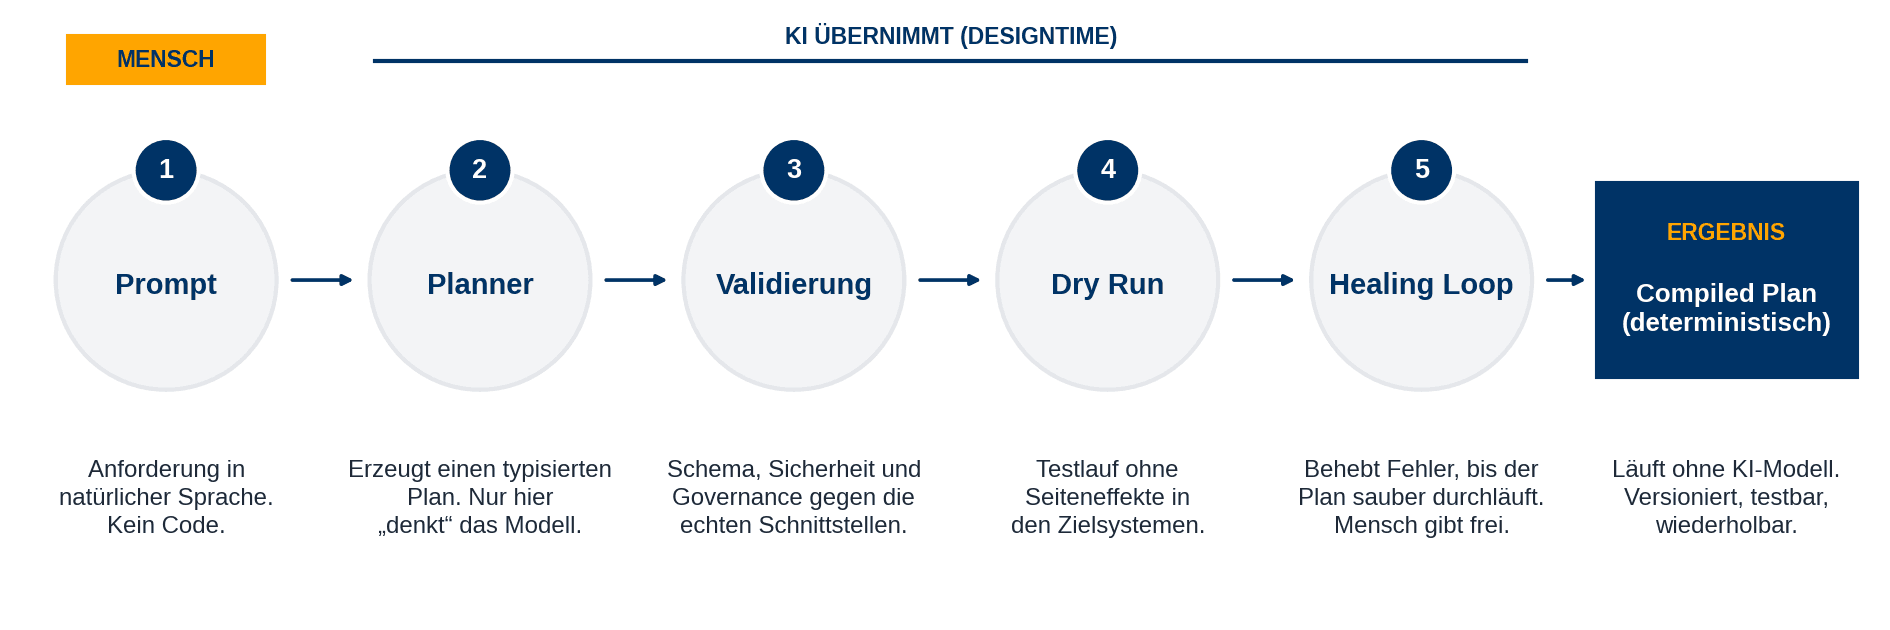
Abbildung 4: Die Designtime in fünf Schritten. Am Ende steht deterministische Software, kein Prompt.
Nach einem Vortrag auf einem Technology Symposium im September 2026 fragte ein Teilnehmer: „Ist das am Ende Software?“ Die Antwort lautet ja. Die KI schreibt die Software, die den Prozess ausführt, innerhalb eines Rahmens, der Sicherheit und Compliance vorgibt. Drei Abgrenzungen helfen bei der Einordnung:
Gegenüber RPA und regelbasierter Automatisierung: Die Regeln schreibt die KI in einem Bruchteil der Zeit, nicht ein Entwicklungsteam über Monate. Änderungen werden in natürlicher Sprache beschrieben und neu kompiliert.
Gegenüber agentischen Workflows: Anthropic unterscheidet Workflows mit vordefinierten Codepfaden von Agenten, die ihr Vorgehen selbst steuern, und rät zur einfachsten Lösung, die funktioniert (10). Compiled AI ist ein Workflow, dessen Code die KI selbst erzeugt.
Gegenüber Prompt-Optimierung wie DSPy: Dort wird der Prompt „kompiliert“, das Modell läuft aber weiterhin bei jedem Aufruf (11).
5. Die Wirtschaftlichkeit
Die Kostenlogik kehrt sich um. Agentisch fallen Modellkosten bei jedem Lauf an. Bei Compiled AI fallen sie beim Bauen und beim Ändern an, die Ausführung kostet nur Rechenzeit auf gewöhnlicher Infrastruktur.
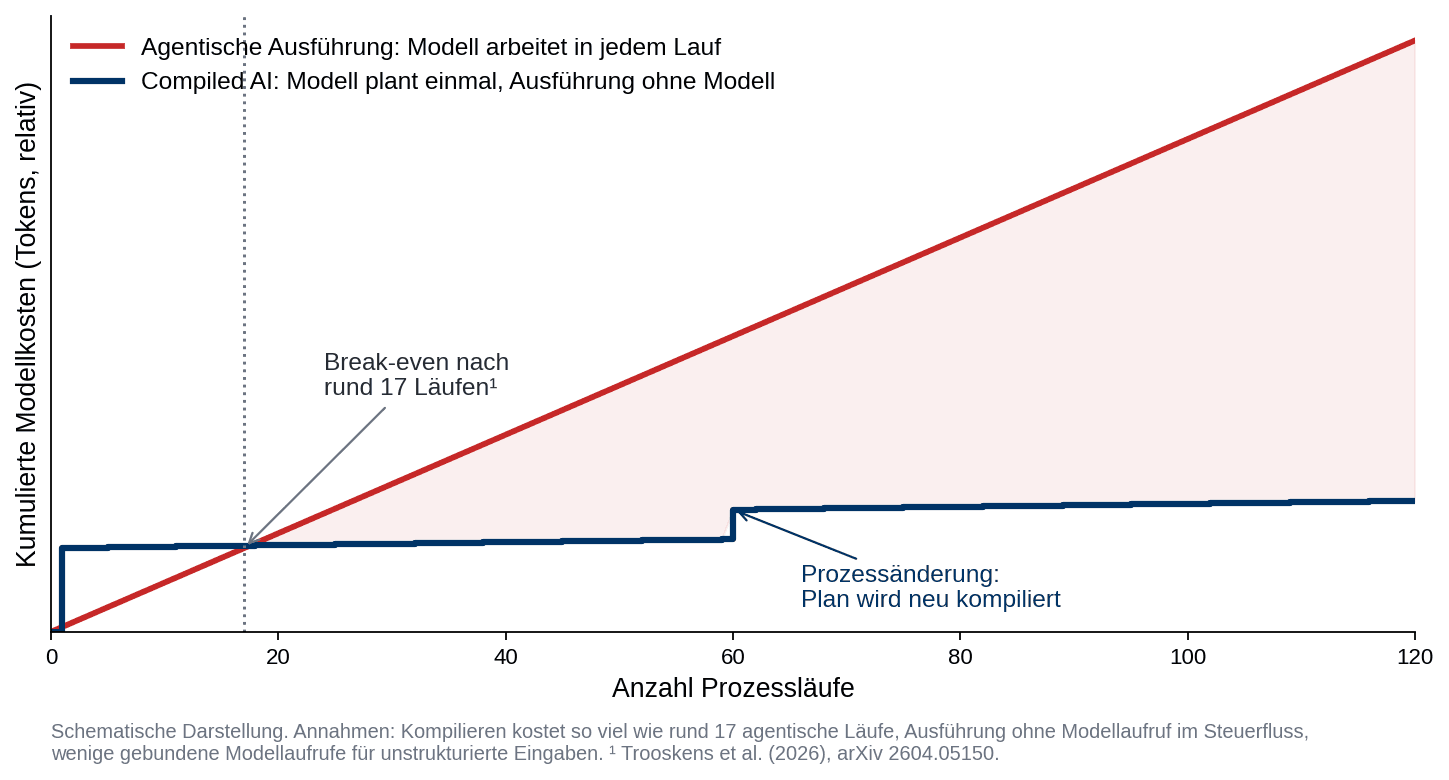
Abbildung 5: Kumulierte Modellkosten. Agentisch wachsen sie mit jedem Lauf, bei Compiled AI fallen sie beim Kompilieren und bei Änderungen an.
Das Forschungspapier (9) liefert die bislang belastbarsten Messwerte:
Kennzahl | Compiled AI im Vergleich zum direkten LLM-Aufruf |
|---|---|
Break-even | nach rund 17 Transaktionen |
Tokenverbrauch bei 1.000 Transaktionen | 57-fach geringer |
Monatliche Kosten bei 1 Mio. Transaktionen | rund 555 USD statt rund 22.000 USD |
Latenz je Funktionsaufruf (Median) | 4,5 ms statt 2.004 ms |
Reproduzierbarkeit des Steuerflusses | 100 % statt 95 % |
Aufgabenerfüllung im Benchmark BFCL | 96 % von 400 Aufgaben, ohne Tokenverbrauch in der Ausführung |
Wichtiger als der konkrete Faktor ist die Struktur. Weil die Kompilierungskosten fix sind und die Ausführung kaum Tokens verbraucht, wächst der Vorteil mit jedem Lauf. Das erklärt, warum Herstellerangaben je nach Volumen zwischen dem 80- bis 100-Fachen (12) und deutlich höheren Faktoren schwanken. Für die Entscheidung zählt: Die Kosten werden vom Volumen entkoppelt.
Hinzu kommt die Bauzeit. Klassische Automatisierung braucht für Prozessaufnahme, Modellierung, Schnittstellenvalidierung und Test typischerweise Wochen bis Monate. Mit Compiled AI entsteht ein ausführbarer Plan in deutlich kürzerer Zeit, weil Modellierung, Validierung und Test automatisiert ablaufen. Der Aufwand verschiebt sich damit von der Implementierung zur sauberen Prozessbeschreibung.
6. Governance, Sicherheit und Betrieb
Für CIOs ist Compiled AI weniger eine Kostenfrage als eine Frage der Beherrschbarkeit. Vier Aspekte stehen im Vordergrund:
Nachvollziehbarkeit. Jeder Lauf folgt demselben versionierten Plan. Welche Planversion welches Ergebnis erzeugt hat, lässt sich lückenlos protokollieren. Der EU AI Act verlangt für Hochrisikosysteme automatische Protokollierung (Art. 12) und menschliche Aufsicht (Art. 14). Die Pflichten wurden durch den AI Omnibus auf Dezember 2027 beziehungsweise August 2028 verschoben (13), die Architekturentscheidung fällt aber jetzt.
Sicherheit. Ist der Steuerfluss fest, können manipulierte Eingaben, etwa eine präparierte E-Mail oder ein PDF mit versteckten Anweisungen, den Prozess nicht umlenken. Forschende von ETH, IBM, Google und Microsoft empfehlen genau dieses Muster als Schutz gegen Prompt Injection (14). Im Paper wurden alle 16 fehlerhaften Pläne bereits beim Kompilieren abgefangen, keiner erst im Betrieb (9).
Souveränität und Datenhoheit. Der ausgeführte Plan braucht kein großes Modell und kann in der eigenen Infrastruktur nahe an den Systemen laufen. Fällt ein Modellanbieter aus, ändert Preise oder kündigt ein Modell ab, läuft der Prozess weiter. Das Modell für die Designtime bleibt austauschbar. Zudem lässt sich steuern, welche Daten ein Modell überhaupt sieht, oft genügen Schemata und Metadaten.
Betrieb. Der Plan ist ein Software-Artefakt. Er wird versioniert, getestet und über einen Änderungsprozess freigegeben, wie jede andere Anwendung. Monitoring konzentriert sich auf Schnittstellen und die wenigen begrenzten Modellschritte.
Aus der Diskussion auf dem Symposium stammt eine pragmatische Reihenfolge für Gespräche mit der IT-Sicherheit: erstens die Daten klassifizieren (öffentlich, intern, kritisch), zweitens die Kritikalität der Entscheidung bewerten (erstellt die KI einen Bericht oder entscheidet sie über Menschen?), drittens den Betriebsort festlegen. Ein kompilierter Prozess erleichtert alle drei Schritte, weil sein Verhalten vorab bekannt ist.
7. Grenzen: wo Compiled AI nicht passt
Ein Architekturprinzip ist nur so gut wie das Wissen um seine Grenzen. Diese sehen wir, teils von den Autoren des Papers selbst benannt:
Seltene oder einmalige Aufgaben erreichen den Break-even nicht. Wer eine Analyse einmal braucht, fragt besser direkt ein Modell.
Offene Aufgaben wie Recherche, Verhandlung, kreative Arbeit oder neuartige Situationen haben keinen stabilen Lösungsweg. Hier bleiben Agenten das richtige Werkzeug.
Das Spezifikationsproblem: Wer einen Prozess nicht beschreiben kann, kann ihn nicht kompilieren. Prozesswissen bleibt Voraussetzung, KI ersetzt es nicht.
Änderungsdynamik: Neue Formulare, geänderte Schnittstellen oder Regeln erfordern ein Neukompilieren. Das ist schnell, braucht aber Regressionstests und einen klaren Freigabeprozess.
Drift in begrenzten Modellschritten: Ein Schema prüft die Struktur einer Extraktion, nicht ihre inhaltliche Richtigkeit. Diese Schritte brauchen Stichproben und Monitoring.
Generierter Code braucht Prüfung: Die automatische Sicherheitsanalyse im Paper erkannte 75 Prozent der unsicheren Code-Muster (9). Menschliche Freigabe bleibt Pflicht.
In Summe verlagert Compiled AI das Risiko aus dem laufenden Betrieb in die Designtime. Dort ist es sichtbar, testbar und freigabefähig, bevor ein Prozess produktiv geht.
8. Praxisbeispiel: das Morgen-Briefing
Wie das konkret aussieht, zeigt eine Demonstration, die wir im September 2026 auf einem Technology Symposium vorgestellt haben. Die Anforderung besteht aus einem einzigen Satz: ein Morgen-Briefing für eine Fertigungslinie über Ressourcenplanung, MES, QMS, Labor, Produktionsplanung, Lieferanten, Wareneingang, Stillstände, OEE und Durchsatz, ergänzt um „weitere wichtige Themen, die ich vergessen habe“. Daraus erzeugt der Orchestrator einen Plan, der die Daten jede Nacht deterministisch aus den Quellsystemen holt, prüft und verdichtet.

Abbildung 6: Ein kompilierter Plan holt, prüft und verdichtet die Daten. Die Systeme bleiben, wie sie sind. Menschen entscheiden.
Das Ergebnis: eine Ampel je Linie, Qualitätsabweichungen mit Ursachen, Stillstandsgründe, Aufträge unter Termindruck, Materialengpässe, offene Entscheidungen für das Stand-up und ein Maßnahmenplan mit Verantwortlichen. Die Demonstration läuft mit Beispieldaten, die Logik ist dieselbe wie im Echtbetrieb.
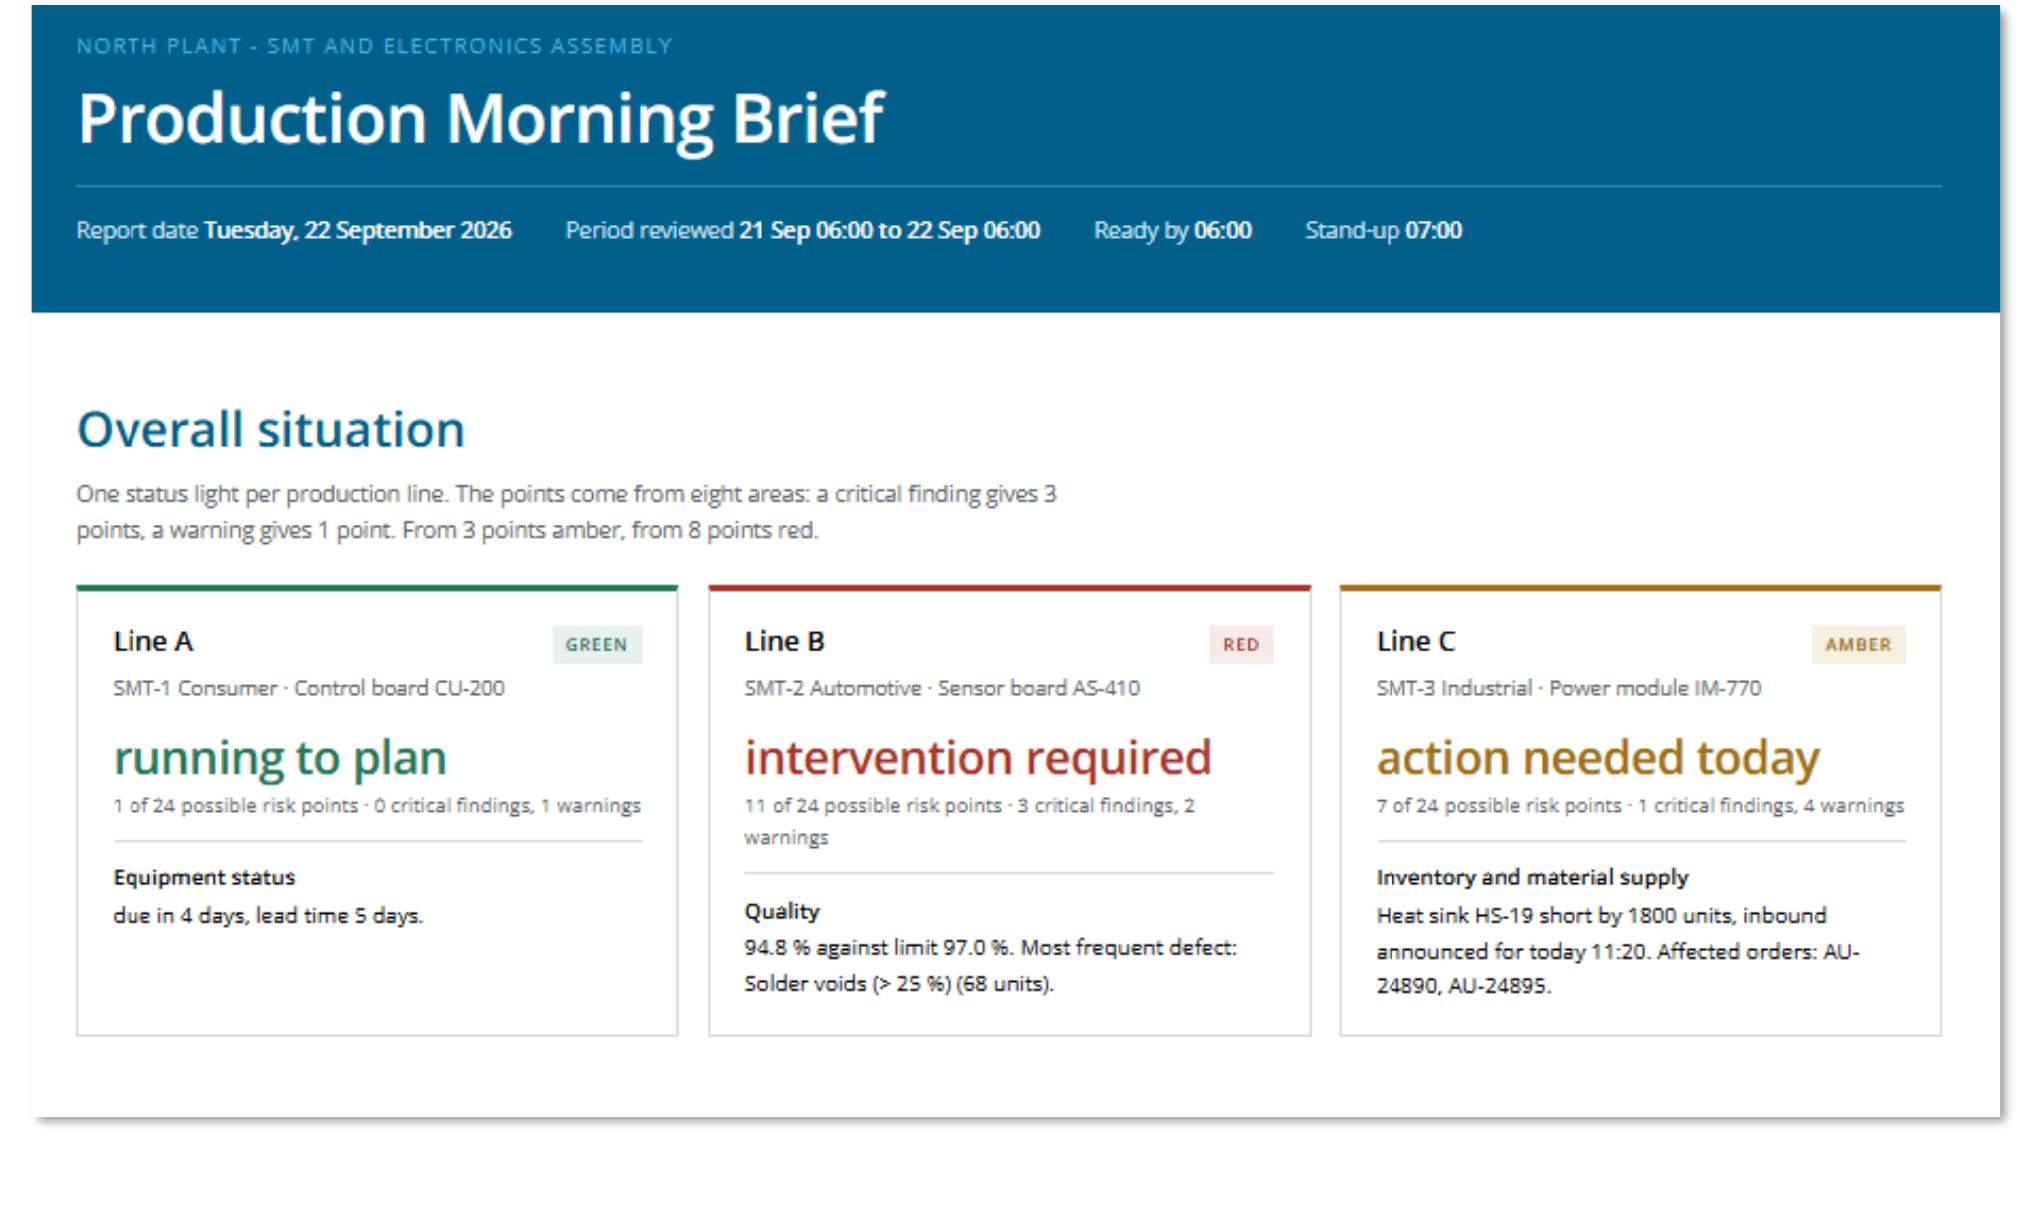
Abbildung 7: Ausschnitt aus dem „Production Morning Brief“, den der kompilierte Plan erzeugt (Demodaten).
Dasselbe Muster in zehn Unternehmensbereichen
Die Produktion ist nur ein Beispiel. Das Muster passt überall dort, wo Menschen regelmäßig Daten aus mehreren Systemen zusammentragen, prüfen und daraus Entscheidungen ableiten:
Bereich | Typische kompilierbare Prozesse |
|---|---|
Finanzen und Shared Services | Prüfung von Eingangsrechnungen, Zahlungsläufe, Monatsreporting |
Einkauf und Supply Chain | Bedarf bis Bestellung, Lieferantenanfragen, Abgleich von Auftragsbestätigungen und Terminen |
Vertrieb und Auftragsabwicklung | Auftragsanlage aus PDF und E-Mail, Angebotsvorbereitung aus Stammdaten |
Kundenservice | Fallakte aus CRM, ERP und Ticketsystem vor dem Rückruf, Garantie- und Kulanzprüfung |
Qualität und Reklamation | Prüfprotokolle, Reklamationsfall bis zum 8D-Entwurf |
Logistik | Frachtausschreibung, Prüfung von Frachtrechnungen |
Compliance und Stammdaten | Leistungserklärungen, Datenblätter, Abgleich von Material-, Lieferanten- und Preisdaten je Standort |
Produktion und Instandhaltung | Schicht- und Störberichte, Wartungsaufträge, Ersatzteilbedarf |
9. Entscheidungsraster und Einstieg
Ob ein Prozess kompiliert oder agentisch ausgeführt werden sollte, lässt sich an sechs Kriterien festmachen:
Kriterium | Spricht für Compiled AI | Spricht für agentische Ausführung |
|---|---|---|
Häufigkeit | täglich, wöchentlich, hohes Volumen | selten oder einmalig |
Struktur | stabile Abfolge, bekannte Systeme | jedes Mal ein anderer Lösungsweg |
Anspruch an das Ergebnis | reproduzierbar, prüfbar, auditierbar | Varianz akzeptabel oder erwünscht |
Eingaben | strukturiert oder in feste Schemata überführbar | offen und unvorhersehbar |
Fehlerkosten | hoch: Geld, Qualität, Compliance | gering, ein Mensch prüft ohnehin |
Datenhoheit | Betrieb in eigener Infrastruktur gewünscht | Cloud-Modell unkritisch |
Faustregel: Wenn Sie den Prozess einer neuen Kollegin als Checkliste erklären können, gehört er in die Compiled-Klasse. Wenn Sie ihr stattdessen sagen würden „schau mal, was Du findest“, ist er ein Fall für einen Agenten.
Fünf Schritte zum ersten kompilierten Prozess
Inventur manueller Routinearbeit: Wo tragen qualifizierte Mitarbeitende regelmäßig Daten aus drei oder mehr Systemen zusammen? Priorisieren Sie nach Häufigkeit, Zeitaufwand und Fehlerkosten.
Daten und Schnittstellen klären: Datenklassifizierung, Zugriffe, vorhandene APIs. Hier entscheidet sich die Umsetzbarkeit, nicht beim Modell.
Pilot mit einem Berichtsprozess: geringes Risiko, hohe Sichtbarkeit, klar messbar in Stunden, Durchlaufzeit und Fehlerquote.
Betriebsmodell festlegen: Wer verantwortet den Plan, wer gibt Änderungen frei, wie werden Regressionstests und Monitoring organisiert?
Entlang des Musters skalieren: Der zweite Prozess ist deutlich schneller als der erste, weil Schnittstellen und Governance bereits stehen.
Marktbeispiel: INXM Orchestrator
Die INXM GmbH aus Berlin wurde 2025 gegründet und kam im Juni 2026 mit einer Pre-Seed-Finanzierung über 5,7 Mio. Euro unter Führung von Cherry Ventures und Redstone aus dem Stealth-Modus (15). Das Gründerteam bringt Erfahrung aus Isar Aerospace, n8n und dem Industrievertrieb von Siemens mit.
Der Orchestrator setzt das Compiled-AI-Prinzip als „Process Execution Engine“ um: KI erzeugt, validiert und verbessert einen Plan, der anschließend deterministisch über ERP, MES, PLM, QMS und weitere Systeme läuft, mit Audit-Trail, menschlicher Freigabe und Rollback. Betrieben wird in der EU-Cloud mit Frankfurt als Primärregion, eine Open-Source-Desktopversion (INXM Local) ermöglicht den Einstieg (16).
Transparenzhinweis: AI CONSULT ist Implementierungspartner von INXM und unterstützt Kunden bei der Prozessaufnahme sowie der Automatisierung von Unternehmensprozessen mit Lösungen wie INXM.
10. Fazit
Die Debatte um KI in Unternehmen kreist noch immer um die Frage, welches Modell das beste ist. Für die meisten Prozesse ist sie entschieden: Die Modelle sind gut genug. Was fehlt, ist eine Ausführungsschicht zwischen Menschen und Systemen, die verlässlich, kostenstabil und prüfbar arbeitet, ohne dass die bestehende Systemlandschaft ersetzt werden muss.
Compiled AI liefert diese Schicht, indem es der KI eine klare Rolle gibt: Sie denkt, plant und baut, einmal und gründlich. Ausgeführt wird ein geprüfter Plan. Das löst drei der drängendsten Themen der aktuellen KI-Einführung zugleich: Die Ausführung kritischer Prozesse wird unabhängig von großen Modellanbietern, die Kosten werden planbar, und jeder Lauf liefert dasselbe Ergebnis.
Das heißt nicht, dass jeder Prozess kompiliert werden muss. Für offene, seltene oder kreative Aufgaben bleiben Agenten das bessere Werkzeug. Die Frage für 2027 lautet deshalb nicht mehr, ob KI in die Kernprozesse kommt, sondern an welcher Stelle sie dort arbeitet: bei jedem Lauf oder einmal, beim Bauen. Wer diese Frage pro Prozess sauber beantwortet, bekommt die Geschwindigkeit der KI und die Verlässlichkeit von Software. Welche drei Prozesse in Ihrem Unternehmen würden Sie morgen kompilieren?
Über den Autor
Nicolas Bartschat ist Gründer und Geschäftsführer der AI CONSULT GmbH in München. Nach rund acht Jahren in der Elektronikfertigung und im industriellen Service berät er Organisationen herstellerneutral bei der Einführung von KI- und Automatisierungslösungen, mit Fokus auf Praxistauglichkeit und messbarem ROI. Er ist regional in der Leitung des KI Bundesverbands Bayern engagiert.
nb@aiconsult.group | +49 175 8713939 | aiconsult.group | linkedin.com/in/nicolas-bartschat
Quellen
(1) MIT NANDA (2025): The GenAI Divide. State of AI in Business 2025. Zusammenfassung: theregister.com/2025/08/18/generative_ai_zero_return_95_percent
(2) He, H. / Thinking Machines Lab (2025): Defeating Nondeterminism in LLM Inference. thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference
(3) Yao, S. et al. (2024): τ-bench. A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045
(4) Appenzeller, G. / a16z (2024): Welcome to LLMflation. a16z.com/llmflation-llm-inference-cost
(5) Epoch AI (2025): LLM inference prices have fallen rapidly but unequally across tasks. epoch.ai/data-insights/llm-inference-price-trends
(6) Google (2025): Google I/O 2025 Keynote, Sundar Pichai, 20.05.2025. blog.google
(7) F.A.Z.-Grafik auf Basis von Prognosen von BCG, Gartner und Goldman Sachs (2026); ergänzend EY US AI Pulse Survey.
(8) Gartner (2025): Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. Pressemitteilung vom 25.06.2025. gartner.com/en/newsroom
(9) Trooskens, G. et al. (2026): Compiled AI. Deterministic Code Generation for LLM-Based Workflow Automation. arXiv:2604.05150
(10) Schluntz, E. / Zhang, B., Anthropic (2024): Building Effective AI Agents. anthropic.com/engineering/building-effective-agents
(11) Khattab, O. et al. (2023): DSPy. Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714
(12) ai.berlin (2026): Alex Oelling, CEO von INXM. ai.berlin/de/news/detail/alex-oelling-ceo-von-inxm (Herstellerangabe)
(13) White & Case (2026): EU AI Omnibus enters into force, amending the AI Act. whitecase.com
(14) Beurer-Kellner, L. et al. (2025): Design Patterns for Securing LLM Agents against Prompt Injections. arXiv:2506.08837
(15) tech.eu (2026): INXM raises €5.7M to tackle enterprise AI execution challenges, 03.06.2026. tech.eu
(16) INXM GmbH: inxm.ai und inxm.ai/data-security, abgerufen am 24.09.2026